

تیم برنامهنویسی پیاستور
هزینه سفارش:
۲۹۹,۰۰۰ تومان
تخصصی و منحصر به فرد بودن این اثر، تضمین کننده بهای محصول نسبت به آثار مشابه است.
محصول حاضر، سورس کد کامل تشخیص نفوذ با الگوریتم یادگیری KNN در متلب است که در آن دیتاست استاندارد و شناختهشده NSL-KDD با استفاده از الگوریتم K نزدیکترین همسایه (K-Nearest Neighbors) دستهبندی میشود. این پروژه برای دانشجویان رشتههای مهندسی کامپیوتر، فناوری اطلاعات، امنیت شبکه، هوش مصنوعی، یادگیری ماشین و علوم داده تهیه شده است و میتواند به عنوان یک نمونه عملی برای اجرای الگوریتمهای طبقهبندی در محیط MATLAB مورد استفاده قرار گیرد.
این پکیج علاوه بر سورس کد MATLAB، شامل فیلم آموزشی نحوه اجرا و توضیحات کلی برنامه و همچنین گزارش کار ۵ صفحهای در قالب فایل Word است. به همین دلیل، محصول تنها یک کد خام نیست؛ بلکه مجموعهای آماده برای یادگیری، اجرا، تحلیل و ارائه دانشگاهی محسوب میشود.
سیستم تشخیص نفوذ، یک سامانه نرمافزاری یا سختافزاری است که وظیفه آن بررسی فعالیتهای شبکه، شناسایی رفتارهای غیرعادی و تشخیص دسترسیهای غیرمجاز است. این سیستم میتواند ترافیک ورودی و خروجی شبکه را تحلیل کند و در صورت مشاهده الگویی مشکوک، آن را به عنوان یک فعالیت عادی یا حمله دستهبندی نماید.
در یک شبکه معمولی، حجم زیادی از دادهها در هر لحظه میان کاربران، سرورها و تجهیزات مختلف جابهجا میشود. بررسی دستی این اطلاعات تقریباً غیرممکن است. در چنین شرایطی، الگوریتمهای یادگیری ماشین میتوانند با آموزش روی دادههای قبلی، الگوهای مختلف ترافیک را یاد بگیرند و نمونههای جدید را به صورت خودکار طبقهبندی کنند.
سیستم تشخیص نفوذ معمولاً در کنار فایروالها مورد استفاده قرار میگیرد. فایروال بر اساس قوانین از پیش تعریفشده، دسترسیها را محدود یا مسدود میکند؛ اما سیستم IDS بیشتر بر مشاهده، تحلیل و تشخیص رفتارهای مشکوک تمرکز دارد. این دو ابزار در کنار یکدیگر میتوانند سطح امنیت شبکه را افزایش دهند.
سیستمهای تشخیص نفوذ بر اساس روش تحلیل و شناسنی بر الگو یا امضا
در روش مبت میشوند.
در روش مبتنی بر الگو که با عنوان Misuse Detection یا Signature-based Detection نیز شناخته میشود، سامانه از مجموعهای از امضاها و الگوهای مربوط به حملات شناختهشده استفاده میکند. اگر ترافیک جدید با یکی از الگوهای ذخیرهشده مطابقت داشته باشد، به عنوان حمله شناسایی میشود.
این روش در تشخیص حملات شناختهشده عملکرد مناسبی دارد، اما در برابر حملات جدید، ناشناخته یا تغییریافته محدودیت دارد. اگر الگوی حمله از قبل در پایگاه داده سیستم ثبت نشده باشد، امکان شناسایی آن کاهش پیدا میکند.
در روش مبتنی بر ناهنجاری یا Anomaly Detection، رفتار معمول شبکه یا سیستم با استفاده از دادههای آموزشی مدلسازی میشود. سپس نمونههای جدید با الگوی یادگرفتهشده مقایسه میشوند. هر نمونهای که تفاوت معناداری با رفتار عادی داشته باشد، میتواند به عنوان فعالیت مشکوک یا حمله شناسایی شود.
الگوریتمهای یادگیری ماشین مانند KNN، درخت تصمیم، نایو بیز، ماشین بردار پشتیبان و شبکههای عصبی در این روش کاربرد فراوانی دارند. پروژه حاضر نیز با استفاده از الگوریتم KNN، نمونههای موجود در دیتاست NSL-KDD را به کلاسهای مختلف ترافیکی دستهبندی میکند.
الگوریتم K-Nearest Neighbors یا به اختصار KNN یکی از سادهترین و در عین حال کاربردیترین الگوریتمهای یادگیری ماشین برای مسائل طبقهبندی است. این الگوریتم از خانواده روشهای یادگیری مبتنی بر نمونه یا Instance-Based Learning محسوب میشود.
برخلاف برخی مدلها که در مرحله آموزش یک ساختار آموزش یک ساختار پیچیده و مستقل ایجاد میکنند، KNN بخش عمدهای آموزشی را در اختیار نگه میدارد و هنگام دریافت نمونه جدید، نزدیکترین نمونههای آموزشی به آن را پیدا میکند. سپس با بررسی برچسب همسایهها، کلاس نمونه جدید تعیین میشود.
برای مثال، اگر مقدار KKK برابر با ۵ باشد، الگوریتم پنج نمونه آموزشی نزدیک به نمونه موردنظر را پیدا میکند. اگر بیشتر این همسایهها در کلاس حمله قرار داشته باشند، نمونه جدید نیز به عنوان حمله دستهبندی خواهد شد. اگر اکثریت همسایهها مربوط به ترافیک عادی باشند، خروجی الگوریتم کلاس نرمال خواهد بود.
فرآیند عملکرد الگوریتم KNN در این پروژه را میتوان در چند مرحله اصلی خلاصه کرد:
یکی از رایجترین معیارهای فاصله در KNN، فاصله اقلیدسی است. در دادههای شبکه، مقیاس ویژگیها ممکن است با یکدیگر متفاوت باشد. برای نمونه، بسیار بزرگ داشته باشد است بین صفر و یک تغییر کند، در حالی که ویژگی دیگری مقادیر بسیار بزرگ داشته باشد. در چنین شرایطی، ویژگیهای بزرگتر میتوانند بر محاسبه فاصله اثر بیشتری بگذارند. به همین دلیل، در کد پروژه گزینه استانداردسازی دادهها فعال شده است.
پارامتر K تعداد همسایههایی را مشخص میکند که الگوریتم برای تصمیمگیری بررسی میکند. انتخاب مقدار مناسب برای K تأثیر مستقیمی بر دقت مدل دارد.
اگر مقدار K بسیار کوچک باشد، مدل ممکن است بیش از حد به نویز و نمونههای استثنایی حساس شود. این وضعیت میتواند باعث بیشبرازش یا Overfitting شود. در مقابل، اگر مقدار K بیش از اندازه بزرگ انتخاب شود، مرز میان کلاسها بیش از حد هموار شده و مدل ممکن است جزئیات مهم دادهها را نادیده بگیرد.
در این پروژه مقدار زیر برای الگوریتم در نظر گرفته شده است:
'NumNeighbors', 5
انتخاب مقدار فرد برای K، به ویژه در مسائل دودستهای، میتواند احتمال مساوی شدن تعداد رأیهای کلاسها را کاهش دهد. البته مقدار بهینه K باید بر اساس ویژگیهای دیتاست و نتایج اعتبارسنجی انتخاب شود.
الگوریتم KNN به دلیل ساختار ساده و قابلفهم، در پروژههای دانشگاهی و نمونههای آموزشی بسیار مورد استفاده قرار میگیرد.
در پروژه حاضر، با فعالسازی استانداردسازی دادهها و استفاده از دیتاست استاندارد NSL-KDD، بخشی از چالشهای مربوط به مقیاس ویژگیها مدیریت شده است.
برای آموزش و ارزیابی سیستمهای تشخیص نفوذ، انتخاب دیتاست مناسب اهمیت زیادی دارد. دیتاست NSL-KDD یکی از مجموعهدادههای مشهور در حوزه تحلیل ترافیک شبکه و ارزیابی سامانههای IDS است.
این دیتاست نسخه بهبودیافتهای از KDD Cup 99 محسوب میشود. در نسخههای قدیمیتر، وجود رکوردهای تکراری و نامتوازن بودن دادهها میتوانست باعث ایجاد نتایج غیرواقعی در ارزیابی الگوریتمهای یادگیری ماشین شود. NSL-KDD با کاهش برخی مشکلات نسخه اولیه، بستری مناسبتر برای آزمایش و مقایسه الگوریتمهای تشخیص نفوذ فراهم کرده است.
در ساختار این دیتاست، هر رکورد شامل ۴۲ مقدار است:
ویژگیهای دیتاست، اطلاعات گوناگونی درباره اتصال شبکه را نمایش میدهند؛ از جمله مدت اتصال، نوع پروتکل، سرویس، وضعیت اتصال، تعداد خطاها، تلاشهای ناموفق برای ورود، رفتار ارتباط با میزبانهای دیگر و برخی ویژگیهای آماری ترافیک.
در این سورس کد از سه مجموعه اصلی دیتاست NSL-KDD استفاده میشود:
مجموعه KDDTrain+ برای آموزش الگوریتم به کار میرود. این مجموعه شامل ۱۲۵۹۷۳ نمونه است و نمونههای مربوط به ترافیک عادی و انواع ترافیک حمله را در خود جای داده است.
الگوریتم KNN با استفاده از این دادهها، الگوهای مختلف نمونهها را بررسی میکند. برچسب هر نمونه به مدل کمک میکند تا در مرحله آزمون، نمونههای جدید را به کلاس مناسب اختصاص دهد.
مجموعه KDDTest+ برای ارزیابی عملکرد مدل استفاده میشود. دادههای این بخش در مرحله آموزش مدل دخالت داده نمیشوند و برای بررسی میزان تعمیم الگوریتم مورد استفاده قرار میگیرند.
استفاده از دادههای جداگانه برای آزمون، امکان سنجش واقعیتر عملکرد سیستم را فراهم میکند؛ زیرا مدل باید نمونههایی را دستهبندی کند که در مرحله آموزش مشاهده نکرده است.
مجموعه KDDTest-21 زیرمجموعهای از دادههای آزمون است که نمونههای دشوارتر را شامل میشود. این مجموعه برای بررسی توانایی الگوریتم در مواجهه با دادههای چالشبرانگیزتر اهمیت دارد.
در پروژه، ستونهای مربوط به ویژگیها از ستون مربوط به برچسب جدا میشوند. از آنجا که آخرین ستون هر رکورد به عنوان خروجی یا برچسب هدف در نظر گرفته شده است، دادهها به شکل زیر تقسیم میشوند:
trn_Inputs=KDDTrain(:,1:end-1);
tst_Inputs=KDDTest(:,1:end-1);

trn_Outputs=KDDTrain(:,end);
tst_Outputs=KDDTest(:,end);
در این قطعه کد:
trn_Inputs ویژگیهای دادههای آموزشی را نگهداری میکند.tst_Inputs ویژگیهای دادههای آزمایشی را شامل میشود.trn_Outputs برچسب نمونههای آموزشی است.tst_Outputs برچسب واقعی نمونههای آزمون را نگهداری میکند.این تفکیک، یکی از مراحل اساسی در مسائل یادگیری نظارتشده است؛ زیرا الگوریتم باید از یک سو ویژگیها را دریافت کند و از سوی دیگر، برچسب واقعی را برای آموزش و ارزیابی در اختیار داشته باشد.
قطعه کد اصلی پروژه به صورت زیر است:
clc, clear, close all
addpath(genpath('Datasets'))

load KDDTrain
load KDDTest
load KDDtest_21

trn_Inputs = KDDTrain(:,1:end-1);
tst_Inputs = KDDTest(:,1:end-1);

trn_Outputs = KDDTrain(:,end);
tst_Outputs = KDDTest(:,end);

%% Test the results
mdl = ClassificationKNN.fit( ...
    trn_Inputs, ...
    trn_Outputs, ...
    'NumNeighbors', 5, ...
    'Standardize', 1);

y_hat_tst = predict(mdl, tst_Inputs);

[c_matrix, Result] = confusion.getMatrix( ...
    tst_Outputs, ...
    y_hat_tst);
clc, clear, close all
این دستورها وظایف زیر را انجام میدهند:
اجرای این دستورات در ابتدای برنامه باعث میشود اجرای جدید پروژه تحت تأثیر دادهها یا نمودارهای باقیمانده از اجرای قبلی قرار نگیرد.
addpath(genpath('Datasets'))
دستور genpath مسیر پوشه Datasets و زیرپوشههای آن را تولید میکند. سپس addpath این مسیرها را به مسیرهای قابل دسترسی متلب اضافه مینماید. به این ترتیب، فایلهای دیتاست از بخشهای مختلف پروژه قابل فراخوانی خواهند بود.
load KDDTrain
load KDDTest
load KDDtest_21
با استفاده از دستور load، دادههای ذخیرهشده در فایلهای متلب وارد Workspace میشوند. پس از بارگذاری، متغیرهای مربوط به دادههای آموزشی و آزمایشی برای استفاده در مرحله آموزش و آزمون آماده هستند.
mdl = ClassificationKNN.fit( ...
    trn_Inputs, trn_Outputs, ...
    'NumNeighbors', 5, ...
    'Standardize', 1);
در این بخش، مدل طبقهبندی KNN ایجاد میشود. پارامتر NumNeighbors تعداد همسایههای مورد استفاده را مشخص میکند و مقدار Standardize با مقدار یک، استانداردسازی دادهها را فعال میسازد.
y_hat_tst = predict(mdl, tst_Inputs);
تابع predict ویژگیهای دادههای آزمون را به مدل میدهد. خروجی آن، برچسب پیشبینیشده برای هر نمونه است. این خروجی در متغیر y_hat_tst ذخیره میشود.
[c_matrix, Result] = confusion.getMatrix( ...
    tst_Outputs, y_hat_tst);
در این مرحله، برچسبهای واقعی با برچسبهای پیشبینیشده مقایسه میشوند. خروجی c_matrix ماتریس اغتشاش و خروجی Result مجموعهای از معیارهای ارزیابی عملکرد مدل است.
استانداردسازی دادهها در الگوریتم KNN اهمیت بسیار زیادی دارد؛ زیرا این الگوریتم بر اساس فاصله میان نمونهها تصمیمگیری میکند. اگر مقیاس ویژگیها متفاوت باشد، متغیرهایی که دامنه بزرگتری دارند میتوانند نتیجه فاصله را تحت تأثیر قرار دهند.
با فعالسازی گزینه زیر، مدل استانداردسازی لازم را در فرآیند آموزش و پیشبینی اعمال میکند:
'Standardize', 1
این کار موجب میشود ویژگیها سهم متعادلتری در محاسبات فاصله داشته باشند.
تنها ساخت مدل یادگیری ماشین برای یک پروژه تشخیص نفوذ کافی نیست. عملکرد مدل باید با استفاده از معیارهای دقیق ارزیابی شود. در مسائل امنیت شبکه، گاهی یک معیار واحد نمیتواند تصویر کاملی از کیفیت سیستم ارائه دهد؛ زیرا تشخیص ندادن یک حمله ممکن است پیامد بسیار جدیتری نسبت به ایجاد یک هشدار اشتباه داشته باشد.
ماتریس اغتشاش، تعداد پیشبینیهای درست و نادرست مدل را برای کلاسهای مختلف نمایش میدهد. در یک مسئله دودستهای، عناصر رایج این ماتریس عبارتاند از:
یکی از نکات مهم در ارزیابی سیستمهای یادگیری ماشین، جلوگیری از ارزیابی مدل روی همان دادههایی است که با آنها آموزش دیده است. اگر مدل روی دادههای آموزشی آزمایش شود، ممکن است عملکردی بسیار بهتر از وضعیت واقعی نشان دهد.
در این پروژه، دادههای KDDTrain+ برای آموزش و دادههای KDDTest+ برای آزمون در نظر گرفته شدهاند. این جداسازی کمک میکند توانایی مدل در تعمیم الگوهای یادگرفتهشده به نمونههای جدید ارزیابی شود.
در صورت نیاز، میتوان از اعتبارسنجی متقابل نیز استفاده کرد. در اعتبارسنجی متقابل، داده آموزشی به چند بخش تقسیم شده و مدل در چند مرحله آموزش و ارزیابی میشود. این روش برای بررسی پایداری الگوریتم و انتخاب مقدار مناسب K کاربرد دارد.
MATLAB یکی از محیطهای قدرتمند برای محاسبات عددی، تحلیل داده و پیادهسازی الگوریتمهای یادگیری ماشین است. استفاده از این محیط در پروژه حاضر، مزایای متعددی ایجاد میکند:
ساختار ماتریسی MATLAB باعث میشود عملیات جداسازی ویژگیها، آموزش مدل و پیشبینی دادهها به شکل کوتاه و خوانا انجام شود.
گزارش کار همراه این پروژه در قالب فایل Word تهیه شده و برای ارائه دانشگاهی قابل استفاده است. این گزارش، خلاصهای علمی و کاربردی از مسئله این گزارش، خلاصهای علمی و کاربردی از مسئله، الگوریتم گزارش شامل موارد زیر است:
فایل Word قابل ویرایش است و میتوان اطلاعاتی مانند نام دانشجو، نام استاد، عنوان دانشگاه و مشخصات درس را در آن تغییر داد.
فیلم آموزشی موجود در این پکیج، مراحل اجرای پروژه را به صورت عملی نمایش میدهد. این آموزش برای کاربرانی تهیه شده است که میخواهند پروژه را در MATLAB اجرا کرده و خروجی آن را به شکل صحیح مشاهده کنند.
در فیلم آموزشی، موضوعات زیر بررسی میشوند:
addpath.KDDTrain، KDDTest و KDDtest_21.وجود فیلم آموزشی باعث میشود کاربر علاوه بر دریافت کد، نحوه استفاده صحیح از فایلها و روش رفع خطاهای رایج مربوط به مسیر دیتاست یا نسخه متلب را نیز بهتر درک کند.
این سورس کد برای طیف گستردهای از فعالیتهای دانشگاهی قابل استفاده است. دانشجویان میتوانند از آن برای انجام پروژههای درسی، آمادهسازی گزارش کار، ارائه کلاسی و ساخت نمونه اولیه یک سیستم تشخیص نفوذ استفاده کنند.
این پروژه برای موضوعات زیر نیز کاربرد دارد:
ساختار پروژه به گونهای است که علاوه بر استفاده مستقیم، امکان مطالعه و توسعه آن را نیز فراهم میکند. کاربر میتواند با بررسی کد، مقدار KKK را تغییر دهد، معیارهای فاصله متفاوت را آزمایش کند یا خروجی الگوریتم را با دادههای مختلف مقایسه نماید.
تهیه یک پروژه تشخیص نفوذ از مرحله آمادهسازی دیتاست تا آموزش مدل، ارزیابی نتایج و تدوین گزارش، به زمان و دانش فنی قابل توجهی نیاز دارد. این محصول بخش اصلی این مسیر را به صورت منسجم و آماده در اختیار شما قرار میدهد.
مهمترین مزایای تهیه پروژه عبارتاند از:
این محصول برای افرادی مناسب است که به دنبال یک نمونه عملی، قابل اجرا و قابل ارائه در زمینه امنیت شبکه و یادگیری ماشین هستند و میخواهند در زمان کوتاهتری پروژه خود را تکمیل کنند.
برای اجرای صحیح سورس کد، لازم است فایلهای دیتاست در پوشهای با نام Datasets قرار داشته باشند و این پوشه در مسیر اصلی پروژه موجود باشد. همچنین فایلهای KDDTrain، KDDTest و KDDtest_21 باید با نامهای مورد انتظار برنامه ذخیره شده باشند.
پیش از اجرای برنامه، بهتر است موارد زیر بررسی شوند:
Datasets در مسیر پروژه موجود باشد.load باشند.رعایت این موارد از خطاهای رایج زمان اجرا جلوگیری کرده و روند اجرای پروژه را سادهتر میکند.
پروژه تشیق یادگیری ماشین و امنیت شبکه است. در این پروژه، نمونهای کاربردی از تلفیق یادگیری ماشین و امنیت شبکه است. در این پروژه، دادههای مربوط به ترافیک شبکه از دیتاست NSL-KDD دریافت شده و با استفاده از الگوریتم K نزدیکترین همسایه طبقهبندی میشوند.
سادگی ساختار KNN، قابلیت استانداردسازی دادهها، امکان تنظیم تعداد همسایهها و توانایی ارزیابی خروجی با استفاده از ماتریس اغتشاش، این الگوریتم را به گزینهای مناسب برای آموزش مفاهیم طبقهبندی در حوزه تشخیص نفوذ تبدیل کرده است.
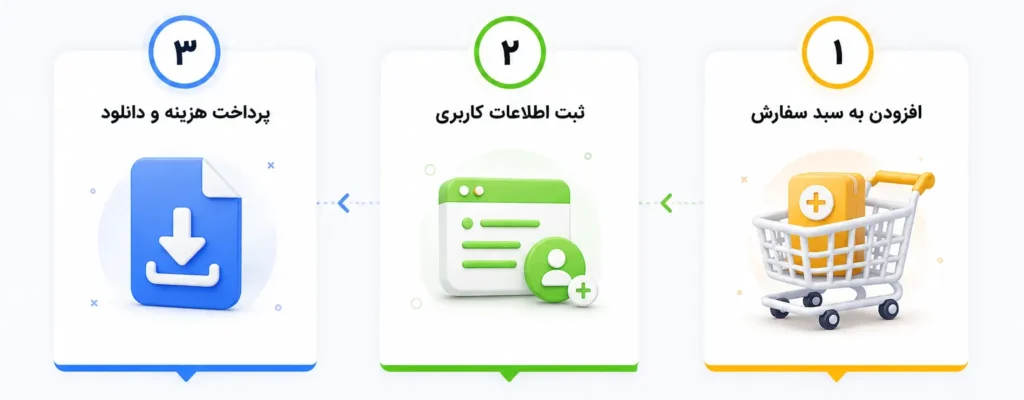
این محصول همراه با سورس کد متلب، گزارش کار ۵ صفحهای Word و فیلم آموزشی آماده شده و توسط گروه پشتیبانی پیاستور تست و اجرا شده است. پس از خرید، فایلهای پروژه در اختیار شما قرار میگیرد و میتوانید از آن برای یادگیری، تکمیل پروژه دانشگاهی، تهیه گزارش و آمادهسازی ارائه استفاده کنید.
برای مشاهده ویدیوی هر بخش، روی عنوان آن کلیک کنید.
تیم برنامه نویسی پی استور یکی از اولین گروههای تشکیل شده در مجموعه آموزشی پی استور میباشد. این تیم از اساتید مجرب و فارغ التحصیلان رشتههای فنی و مهندسی تشکیل شده که در زمینههای مختلف برنامهنویسی و تهیه سورس کد فعال هستند.
اطلاعات و جزئیات کامل این محصول
جهت تسلط عمیقتر و تکمیل مهارتهای خود، یادگیری این سرفصلها پیشنهاد میشود.


هزینه سفارش:
۲۹۹,۰۰۰ تومان


دیدگاهها و نظرات
مدیریت و پشتیبانی
نظرات خود را با ما در میان بگذارید.