

تیم برنامهنویسی پیاستور
هزینه سفارش:
۳۵۹,۰۰۰ تومان
تخصصی و منحصر به فرد بودن این اثر، تضمین کننده بهای محصول نسبت به آثار مشابه است.
سورس کد آماده تشخیص سرطان سینه با شبکه عصبی در متلب (MATLAB) یک پروژه تخصصی، کامل و اعتبارسنجیشده است که با بالاترین نرخ دقت، فرآیند پیشپردازش دادههای بالینی، پاکسازی دادههای گمشده، نرمالسازی ویژگیها، طراحی ساختار شبکه عصبی، آموزش و آزمون مدل و استخراج تمامی معیارهای آماری و تشخیصی استاندارد را در محیط متلب پیادهسازی کرده است. این پکیج نرمافزاری ابزاری فوقالعاده برای دانشجویان، محققان علوم داده و مهندسان هوش مصنوعی است که قصد دارند یک مدل هوشمند بدون خطا را برای مقالات علمی، پروژههای دانشگاهی یا پایاننامههای خود به کار بگیرند.
شبکههای عصبی مصنوعی (Artificial Neural Networks) به دلیل توانمندی بالا در شناسایی الگوهای پیچیده و نگاشتهای غیرخطی میان ویژگیهای فیزیولوژیکی و بافتی، بهترین گزینه برای دستهبندی تودههای مشکوک به شمار میآیند. دادههای پزشکی حاصل از بیوپسی یا تصویربرداری اغلب دارای همپوشانیهای ظریف و پیچیدهای هستند که الگوریتمهای خطی قادر به تفکیک آنها نیستند. شبکه عصبی با یادگیری روابط میان ریسک فاکتورهای متعدد بافتی، مدل تعمیمپذیری میسازد که میتواند تودهها را با اطمینان بسیار بالا به دو گروه خوشخیم (Benign) یا بدخیم (Malignant) تفکیک کند.
این پروژه نه تنها ساختار شبکه عصبی را به شکل کاملاً بهینه تعریف میکند، بلکه تمامی چالشهای دادههای واقعی مانند مقادیر ناموجود (Missing Values) و ناهمگنی مقیاس دادهها را به شکل خودکار برطرف ساخته و فرآیند یادگیری را در بالاترین سطح کیفی تضمین مینماید.
اعتبار علمی و دقت مدلهای یادگیری ماشین وابسته به کیفیتی است که در دادههای ورودی وجود دارد. این سورس کد بر پایه مجموعه داده استاندارد سرطان سینه دانشگاه کالیفرنیا، ارواین (UCI Machine Learning Repository) تدوین شده است. این مجموعه داده بالینی شامل مشخصات نمونههای بافتی جمعآوریشده از بیماران است که ۹ ویژگی ساختاری و مورفولوژیکی هسته سلولها را مورد سنجش قرار میدهد.
ویژگیهای تخصصی موجود در این دیتاست عبارتاند از:
ستون نهایی این مجموعه داده، متغیر هدف (کلاس دستهبندی) است که وضعیت بیمار را به صورت خوشخیم (با برچسب عددی ۲) یا بدخیم (با برچسب عددی ۴) مشخص میسازد.
دادههای خام پزشکی هرگز نباید بدون پیشپردازش وارد شبکه عصبی شوند، زیرا وجود نویز، دادههای گمشده و مقیاسهای ناهمگون سبب تخریب وزنهای شبکه و کاهش دقت تشخیصی میشود. در این پروژه، مراحل پیشپردازش به صورت استاندارد زیر انجام شده است:
از مجموع ۶۹۹ رکورد اولیه موجود در دیتاست، ۱۶ رکورد دارای مقادیر ثبتنشده در ستون هستههای عریان بودند. برای جلوگیری از خطای محاسباتی، سطرهای ناقص به طور کامل حذف شدند و یک ماتریس تمیز و یکپارچه شامل ۶۸۳ نمونه معتبر استخراج گردید.
شماره شناسه (Sample ID) بیماران تنها یک متغیر اداری است و هیچ اطلاعات بالینی مفیدی برای شبکه عصبی فراهم نمیکند. این ستون به طور کامل از ماتریس یادگیری حذف شده تا از بیشبرازش (Overfitting) روی شناسههای ساختگی جلوگیری شود.
برای همگنسازی بازه تغییرات مقادیر و بهینهسازی سرعت همگرایی توابع فعالیت در شبکه عصبی، دادهها به بازه عددی استاندارد بین ۰ و ۱ نگاشت شدند. این کار خطای گرادیان را کاهش داده و تطبیق دادهها را با مدل هوشمند تسریع میبخشد.
فایل نهایی این دادههای پالایششده در نرمافزار متلب با نام استاندارد IOdata ذخیره شده و به طور مستقیم به هسته شبکه عصبی تزریق میشود.
یکی از نقاط قوت برجسته این سورس کد متلب، محاسبه خودکار و دقیق جامعترین پکیج معیارهای ارزیابی یادگیری ماشین در پنجره فرمان (Command Window) است. پس از اتمام اجرای شبیهسازی، شاخصهای زیر به صورت کاملاً تفکیکشده نمایش داده میشوند:
علاوه بر شاخصهای متنی، برنامه خروجیهای تصویری و گرافیکی متعددی را در پنجرههای مجزا ترسیم میکند که به طور کامل آماده درج در مقالات و گزارشهای علمی است:
پس از انجام شبیه سازی خروجی های مربوط به پارامترهای دقت، صحت، Recall، F1 و معیار های آماری کاپا، میانگین خطای مطلق (MAE)، ریشه میانگین مربعات خطا (RMSE)، خطای نسبی مطلق (RAE)، ریشه نسبی مربعات خطا (RRSE) در Command Windows متلب قابل مشاهده است. تصاویری از خروجی نمودارها در پروژه تشخیص سرطان سینه با شبکه عصبی در ادامه آورده شده است.


IOdata در کنار فایل اصلی سورس کد قرار داده شده است و نیازی به دریافت دادههای جداگانه نیست.پیادهسازی یک شبکه عصبی پایدار برای دادههای حساس پزشکی نیازمند آگاهی عمیق از مراحل پاکسازی داده، تنظیم پارامترهای لایهها و فرمولهای پیچیده ارزیابی آماری است. با تهیه این سورس کد، شما به یک پروژه تستشده، علمی و بینقص دسترسی خواهید داشت که دارای فایل راهنمای داخلی بوده و مراحل اجرای آن از بارگذاری تا ترسیم نمودارها بدون هیچگونه پیچیدگی و سردرگمی پیش میرود.
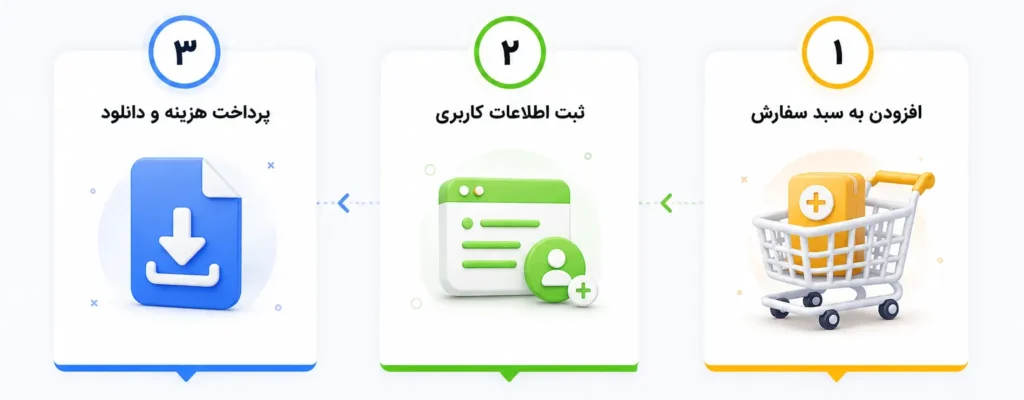
این سورس کد به صورت جامع توسط کارشناسان فنی بررسی و اعتبارسنجی شده و دارای نشان تضمین کیفیت پیاستور است. پس از پرداخت آنلاین از طریق درگاههای امن بانکی شبکه شتاب، لینک دانلود فایل فشرده (ZIP) حاوی سورس کدهای متلب، دیتاست و توضیحات راهنما به صورت آنی در پنل کاربری شما فعال و آماده دریافت خواهد بود.
تیم برنامه نویسی پی استور یکی از اولین گروههای تشکیل شده در مجموعه آموزشی پی استور میباشد. این تیم از اساتید مجرب و فارغ التحصیلان رشتههای فنی و مهندسی تشکیل شده که در زمینههای مختلف برنامهنویسی و تهیه سورس کد فعال هستند.
اطلاعات و جزئیات کامل این محصول
جهت تسلط عمیقتر و تکمیل مهارتهای خود، یادگیری این سرفصلها پیشنهاد میشود.



هزینه سفارش:
۳۵۹,۰۰۰ تومان

دیدگاهها و نظرات
اکبر صدوقی
ممنون همون چیزی بود که می خواستم
مدیریت و پشتیبانی
نظرات و دیدگاه های خود را با ما درمیان بگذارید.